AI 翻译为什么不再只是“一句话互译”?从有道的文档、OCR、润色与 API 看任务变化
直接答案:AI 翻译现在最大的变化,不只是“一句话翻得更自然”,而是输入和输出都变了。短文本仍然存在,但整份文档、图片/OCR、音视频、网页、论文、润色改写和 API 已经变成不同任务入口。真正重要的能力,不是把这些都叫成“AI”,而是知道每个任务什么状态才算完成。
想实际体验这些任务入口,桌面端未准备好时可先从有道翻译下载入口开始;本文重点不是下载,而是解释文档、OCR、润色和 API 为什么已经变成不同任务。
以前最典型的翻译任务只有两格
输入一段文字,选择语言,得到译文。这种模式最容易评价:语言方向对不对、句意有没有错、数字和专有名词有没有变化。现在这个基础任务仍然存在,但已经不再覆盖用户全部需求。
文档把“文件结构”带进翻译
PDF、Word、PPT 的问题不只有文字本身,还有页次、双栏、表格、图片、公式和扫描页。当前有道翻译公开页面仍把文档翻译作为独立功能;这意味着“译文正确”之外,还多了文件解析和结构完整性两个验收维度。
一页能翻不代表整份文档完成。开头、中间、结尾是否完整,扫描页是否被识别,已经成为新的成功条件。
OCR 让“图片里的字”进入翻译链路
图片、扫描件和软件界面不能直接当普通文本处理。先识别原文,再翻译,所以系统实际变成两级:
图片 → OCR 原文 → 翻译结果这也增加了新的错误类型:如果 OCR 把数字、型号或专有名词读错,译文再自然也没有价值。有道智云当前通用 OCR 文档仍提供文本区域和识别结果,说明识别层本身就是独立能力。
润色把“翻译”扩展成了写作辅助
有些用户并不是看不懂英文,而是已经写出英文,却希望更自然、更正式或更符合学术场景。当前有道翻译页面仍提供“润色改写”,文本润色 API 也会按句给出结果与原句差异。
这类任务的验收标准完全不同:不是“中文是不是变成英文”,而是“表达改善以后,原意、事实、数字和术语有没有保持”。
论文和网页让上下文变得更重要
当前公开产品导航还包括 arXiv 论文翻译、网页翻译、音视频翻译等入口。处理整篇论文或网页时,用户真正关心的是上下文连续性、术语一致、段落关系和信息定位,而不是孤立的一句话。
API 把翻译从“一个人操作”变成工作流
当翻译进入网站、客服、知识库和批量任务,问题又变了。除了译文质量,还要处理鉴权、超时、错误码、重试、术语表和日志。一个错误如果被批量放大,影响会远大于手工翻错一句话。
因此自动化程度越高,结果抽检反而越不能省。
同一个“AI翻译”,至少有五种验收标准
| 任务 | 真正的成功标准 |
|---|---|
| 短文本 | 句意、数字、专名、语言方向正确 |
| 文档 | 内容完整,页次和结构可核对 |
| OCR | 先保证原文识别正确,再看译文 |
| 润色 | 表达改善,但事实和原意不变 |
| API/自动化 | 可监控、可重试、可记录错误并抽检结果 |
为什么本站把这些任务拆成不同文章
如果把文档、OCR、润色、论文、API 全塞进一篇“AI 翻译大全”,每个任务只能讲到表面。拆开以后,每个页面可以有自己的用户状态、操作路径、完成结果和失败边界;这个页面只负责解释这些任务为什么已经不再是同一个问题。
这篇不预测整个 AI 行业
这里不讨论哪家公司模型最强,也不做 ChatGPT、Gemini、DeepL 的泛行业排名。文章只围绕有道当前公开产品里已经存在的文本、文档、OCR、润色和 API 任务,避免主题漂出“有道翻译”实体。
同一个产品里,为什么会出现越来越多独立入口
因为用户任务已经从“把一句话换成另一种语言”扩展成“处理不同介质和工作流”。文档需要保留结构,OCR 需要先读图,润色需要对照原文,API 需要监控和错误处理。这些任务的输入、失败方式和验收标准都不同,所以拆成独立入口反而更符合用户真实工作方式。
AI 能力越强,越不能省略验证
结果生成得更快、更自然,并不代表所有错误都会减少。相反,流畅结果有时更容易让人忽略数字、专有名词、因果关系和事实变化。因此新的使用习惯应该是“先确定任务,再定义完成标准,再验收结果”。
从搜索角度看,用户问题也在变细
用户不再只搜索“怎么翻译”,还会问“扫描 PDF 为什么没有文字”“英文邮件怎么改自然”“API 为什么签名失败”。这些问题表面上都属于翻译,但背后需要完全不同的解决路径。本站把它们拆开,就是为了让每个页面真正完成一个任务,而不是把所有功能堆进一篇大全。
“多场景”不是功能越多越好,而是任务要能闭环
一个新入口只有在用户能明确完成任务时才有价值。文档页要能判断文件是否处理完整,OCR 要能验证原文识别,润色要能比较改写前后,API 要能看到错误码和返回值。只是把功能名称放在导航里,并不能说明任务真正完成。
未来真正值得关注的是“验证成本”
生成结果越来越快以后,用户花在等待上的时间会减少,但花在验收上的时间未必减少。批量处理一百份文档或一千条客服内容时,一次错误可能被复制很多次。因此抽样、术语表、日志、原文对照和失败回退会变得比“生成速度”更重要。
为什么这篇文章不做产品功能大全
功能大全会把每个入口都讲一点,却很难讲清失败状态。这里保留的只是任务变化:文本、文档、图片、写作、自动化各自需要什么验证。真正的操作细节交给独立页面,这样一个搜索问题只由一个主要页面完整回答。

有道翻译
暂无介绍....
延伸阅读:
第一次用有道翻译,文本、文档、截图和润色该选哪个入口?
第一次用有道翻译时,先判断手里的内容是短文本、整份文档、图片/扫描件,还是已经写好的英文。入口选对,比把所有内容都塞进文...
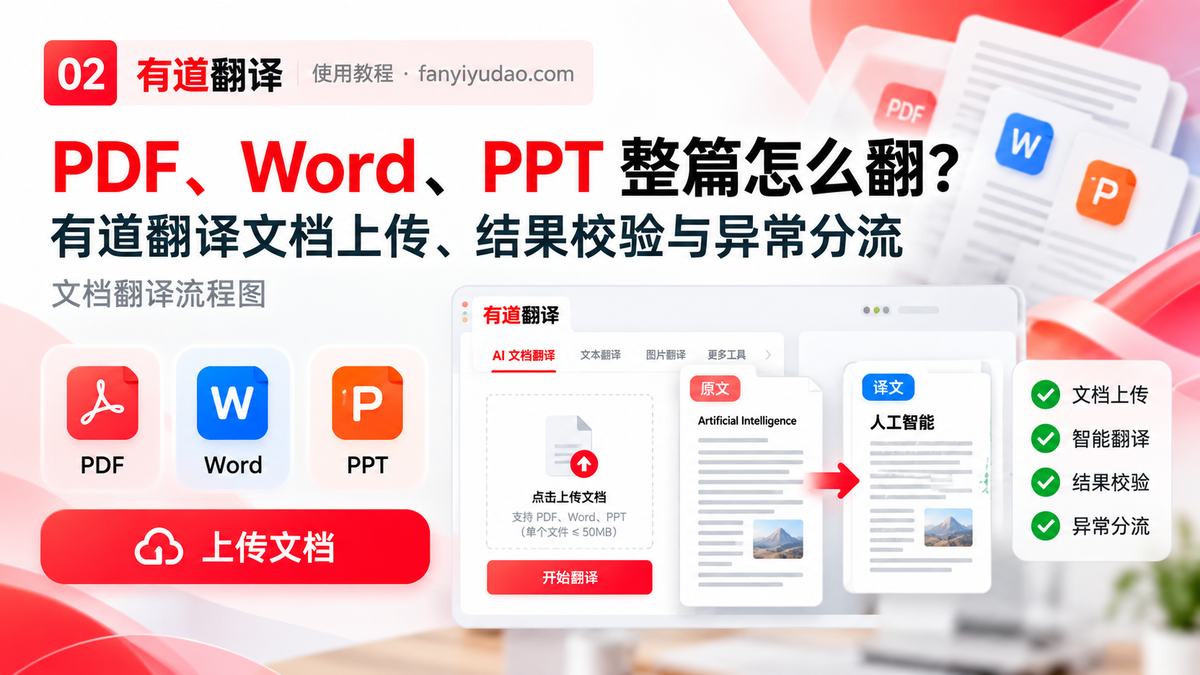
PDF、Word、PPT 整篇怎么翻?有道翻译文档上传、结果检查与异常分流
文档翻译先确认文件可打开、正文是否有文字层,再用小文件验证上传和解析。上传失败、一直解析、结果缺页和扫描件要分开处理。
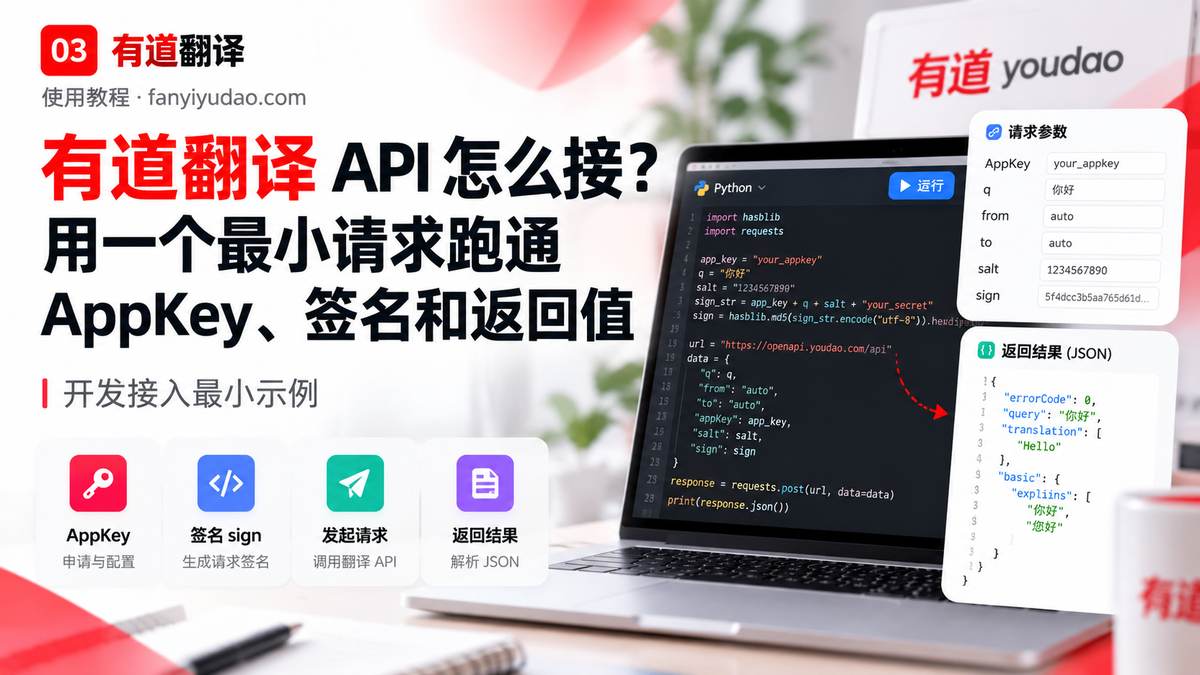
有道翻译 API 怎么接?用一个最小请求验证 AppKey、签名和返回值
API 第一次接入不要直接接完整业务。先用一个最小文本请求验证 AppKey、salt、curtime、sign 和 J...
图片文字选不中怎么办?有道翻译截图 OCR 从框选到译文的完整验证
图片、网页区域、软件界面或扫描页的文字选不中时,先用截图/OCR框一个小区域做基准测试。OCR原文正确以后再评价译文,整...
英文写得生硬怎么改?有道翻译 AI 润色的原文对照、语气调整与验收
AI润色不是把英文重新翻译一遍。先保留原文,按段处理,再比较句式、术语、数字、否定和语气;只有原意没变、场景更合适才接受...